2D 图像拉框标注
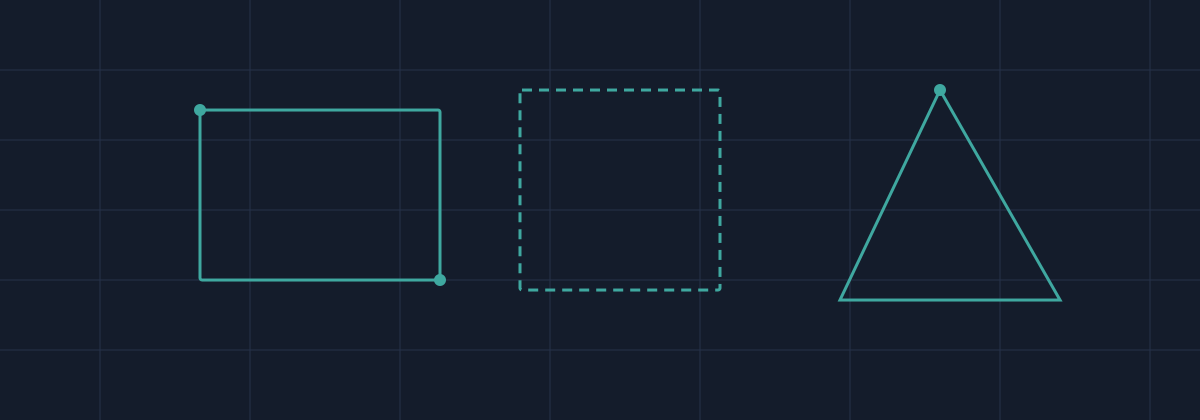
为图像中的目标绘制矩形边界框并赋予类别标签,是目标检测模型最基础的数据形态。框的位置与类别一致性直接决定检测器的召回与误检表现,规范里对压线、遮挡、小目标必须给出明确处理规则。
- 支持 VOC、COCO、YOLO 等常用格式导出
- 适用安防、零售货架、工业缺陷检测场景
- 按张作业,视目标密度与类别数而定
这一页把我们的服务按数据类型拆开讲清楚:每一类标注解决什么模型问题、适合什么业务场景、按什么方式交付。标注不是一个笼统的“外包”概念——拉框看效率,分割看边缘贴合,点云看空间关系,语音看转写一致性。选择服务前,建议先阅读选型与采购指南,再对照下面的条目判断你的需求落在哪一类。如果拿不准,把样例数据发到邮箱 hello@bnpypol.cn,我们先做试标再谈排期。
为图像中的目标绘制矩形边界框并赋予类别标签,是目标检测模型最基础的数据形态。框的位置与类别一致性直接决定检测器的召回与误检表现,规范里对压线、遮挡、小目标必须给出明确处理规则。
沿目标轮廓逐点勾绘像素级掩膜,用于实例分割与场景理解模型。分割的难点在边缘贴合度与类别边界归属,我们用放大作业与共识样例来控制偏差,不让“差不多”流入训练集。
在激光雷达采集的三维点云中标定车辆、行人、骑行者等目标的立体包围盒,并处理点云稀疏区域的判断问题。连续帧任务还需保持目标跨帧 ID 一致,我们按轨迹单元作业以减少 ID 跳变。
按固定点位表标定人脸、人体、手部等目标的关节与特征点位置。关键点标注的坑在于遮挡点的处理口径不统一,我们在规范里逐点定义可见、被遮挡、不存在的三种状态,避免标注员自行发挥。
将录音逐句转写为文本并标注说话人与时间戳,可按需求做静音切分与有效语音筛选。口语里的语气词、重复、方言如何转写,都需要事先约定转写规则文档,保证同一种声音现象在不同人手里写法一致。
对票据、证照、手写单据等图像中的文字区域进行框选与逐字转录,为文字识别模型提供图文严格对齐的训练数据。模糊字、印章遮挡、竖排文字的处理规则在开工前逐条确认,转录错误按字符差错率统计。
在连续视频帧上标注目标并保持跨帧 ID 一致,输出目标轨迹数据。视频任务对“目标离开画面再回来算不算同一目标”这类规则尤其敏感,我们在规范文档里逐场景定义,验收时按轨迹完整性抽检。
围绕大语言模型训练需求撰写指令—回答样本,或对多份回答做质量排序与偏好比较。这类任务的质量不在手速而在判断力:撰写员需按领域提示词分布补齐覆盖缺口,偏好标注需双人一致率达标后入库。
对已有数据集做去重、坏例剔除、标签复核与差错归因。很多团队模型迭代遇到瓶颈,问题其实出在存量数据的系统性错标上;复核输出差错分布报告,帮你判断是全量返工还是定向修复更合适。
带着样例数据走一遍试标流程,是判断这家标注供应商是否合适的可靠方法。欢迎阅读选型与采购指南,或写信至 hello@bnpypol.cn 发起合作。